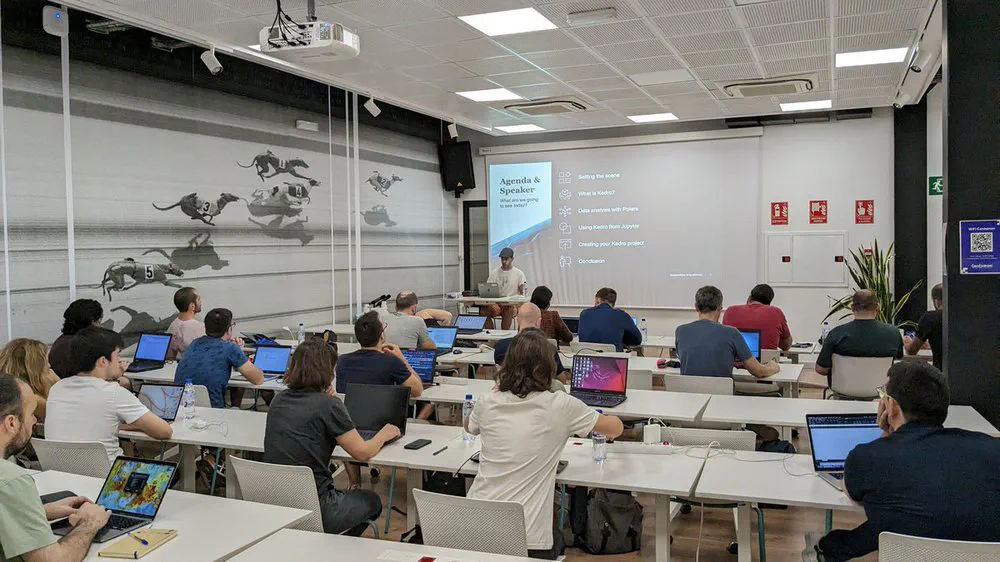
Convierte tus notebooks de Jupyter en código mantenible con Kedro
- Speaker
- Juan Luis Cano Rodríguez
- Event
- PyDataBCN (2023)
- Date
- Type
- Workshop
- Language
- Spanish
- Topic
- (Maintainable) Data Science
- Length
- 75 minutes
About this talk
Los notebooks han sido fundamentales para el surgimiento de la ciencia de datos como campo, ya que brindan una interfaz fácil de usar, ofrecen un feedback rápido, y constituyen tanto un entorno de desarrollo como un formato de intercambio. Sin embargo, también se reconoce ampliamente que a menudo plantean problemas de reproducibilidad y mantenibilidad: el 90 % de los notebooks de Jupyter publicados no indican explícitamente las dependencias de los paquetes (Wang et al, 2021), y el 96 % de ellos contener errores o estado oculto que impidió obtener los mismos resultados después de volver a ejecutar (Pimentel et al, 2019). Se han propuesto varias herramientas y enfoques para mitigar los problemas de los notebooks para datos de producción. ciencia. En este taller, los autores proponen un flujo de trabajo que consiste en la refactorización iterativa de notebooks de Jupyter: mediante la extracción incremental de referencias de datos y lógica de negocio en módulos reutilizables de Python, los participantes serán capaces de explotar las capacidades dinámicas de los notebooks manteniendo su complejidad bajo control. Estos módulos de Python harán uso de Kedro, un framework Python para crear pipelines de datos reproducibles, mantenibles y modulares.
Photos (1)